

本文目的: 針對常見的 wafer 檢測資料異常,皆能透過 Pandas 預處理成乾淨數據
在半導體製程中,要保持製程順暢就要確保人機料法環是穩定的;而在資料工程上也要確保資料乾淨,後續分析才能得到正確結果。但實際上我們從實驗室電腦或是檢測機台上拿到的數據,在做分析時常有這幾種情況:
要刪掉寫著各種檢測時資訊,但不是主要 data 的中介資料 (Metadata)
檢測數據有中介資料是正常的,但每個檔案的中介資料行數不同導致巨集難以處理
分析時找不到指定欄位,找很久bug後才發現表頭 (header) 名稱前或後多一個空格
某 wafer 有缺失值或異常大值,導致繪製 mapping 圖後 scale 很怪異
本篇就是要針對以上問題,使用 Pandas 在資料讀取過程 (本文使用 pd.read_csv ) 中做預處理,避免後續的分析異常。
檢測資料常有各式各樣的副檔名,但是大多實際上是 csv (Comma-Separated Values,逗號分隔值)。因此直接用以下 Pandas 指令就可以讀取檢測檔案
import pandas as pd # Pandas 通常簡寫為pd

df_a_wafer = pd.read_csv(資料路徑) # dataframe
以上的讀取方式只適用於資料第一欄就是表頭的情況,但是檢測資料頭幾列通常是中介資料,需要多一些指令處理。且實際上檢測資料格式是百百種,我就曾經遇過同一系列產品,但是中介資料列數完全不同的資料。因此下面會提供常見的檢測資料處理方式,讓大家分析數據時不用處理格式問題。
中介資料: 描述資料的資料,例如檢測檔案頭幾列的產品名、時間、工號等
本專欄使用之模擬資料如下圖所示,是一組圓形、含有中介資料與表頭的csv檔
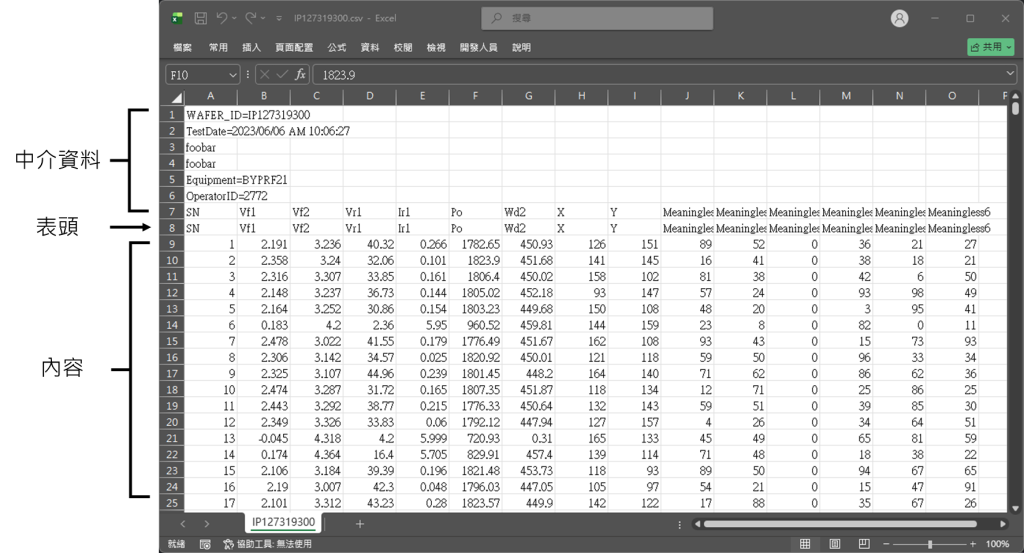
若處理的資料中介資料列數是固定的,那麼使用 skiprows=header_rows 即可省略指定的列數。例如以上圖的資料來說要省略的列數為7。
import pandas as pd
header_rows = 7 # metadata 列數
df_a_wafer = pd.read_csv(a_dir, skiprows=header_rows) # a_dir:檔案路徑
若處理檔案的中介資料列數不同,通常會找尋表頭所在列數,然後一樣使用skiprows=header_rows 。
在這個時候就需要事先一行一行讀取資料,找到表頭後回傳列數,實際code如下:
# 定義找表頭方法
def find_skiprows(file_path:Path, target_keyword:str):

    with open(file_path, 'r', encoding='utf-8') as f: # 打開對應檔案
        reader = csv.reader(f) # 將各列資料字串以欄位分開,並轉成list輸出

        for i, line in enumerate(reader): # 逐行讀取資料

            if target_keyword in line: # 在某行找到關鍵字就退出
                return i

    return 0

# 找尋表頭欄數後傳入pd.read_csv
dynamic_header = find_skiprows(a_dir, 'Vf2') + 1 # 因為表頭重複2次,因此需加1
df_a_wafer = pd.read_csv(a_dir, skiprows=dynamic_header)
在 pd.read_csv 中傳入usecols=需求欄位之list後,就只會讀取 list 內有的欄位。
col_list = ['SN', 'Vf2', 'X', 'Y'] # 檔案一定有的欄位
df_a_wafer = pd.read_csv(a_wafer_path, skiprows=header_rows, usecols=col_list)
但大家一定遇過資料組含有的欄位不同,但需要用同樣的code處理。這時候usecols就要帶入function了
col_list_wmissing_col = ['SN', 'Vf2', 'X', 'Y', 'Wd3'] # Wd3 不在點測檔中
df_a_wafer = pd.read_csv(a_wafer_path, skiprows=header_rows, usecols=lambda x:x in col_list_wmissing_col)
當usecols帶入function時,會將欄位名傳入function,若function回傳True則讀取該欄位。此處lambda x:x in col_list_wmissing_col的意思是驗證x是否有在col_list_wmissing_col內,若有則讀取該欄位。使用此方式指定讀取欄位就不會因為清單內存在df_a_wafer沒有的欄位,而導致ValueError。
有時檢測機台會在表頭處的文字前輸出空白,這些空白可能讓我們影響我們做欄位比對(空白也是字串喔)。用以下的方式就可以優雅的去掉空白
df_a_wafer = pd.read_csv(a_wafer_path, skiprows=header_rows) #讀取wafer資訊
df_a_wafer.columns = df_a_wafer.columns.str.strip()
上述的df_a_wafer.columns是 Pandas 的 Index ,專門在描述表頭(欄名)或是索引(列名)的物件。我們將df_a_wafer.columns套用str後即可沿用字串的strip()方法,去掉表頭內前後的空白。
異常大值或是缺失值會在 mapping 與統計上引發異常,但這些都可以事先處理掉。
若要填補缺失值,使用fillna並指定填補值就可以。另外inplace=True代表原本的dataframe會被修改,Pandas 內有很多像這樣要另外宣告才會修改原檔案的設計,使用時要特別注意。
# 用0填補缺失值
df_a_wafer.fillna(0,inplace=True) # 0 是填補值
若要取代異常大值,需要使用mask。mask可以指定條件後,將other=0的值套用到符合df_a_wafer>5000的欄位上。
# 將異常大值替代為指定值
df_a_wafer.mask(df_a_wafer>5000, other=0, inplace=True) # 5000 為異常大值
若想知道異常值在哪幾列,可以使用以下方式
# 以找缺失值為例
w_missing_value = (df_a_wafer.isna()).any(axis=1) # 回傳一個裝bool的series
df_a_wafer[w_missing_value].index.tolist()
# 將'bool的series'當作篩選條件傳入dataframe中
Pandas的dataframe可以用dataframe[boolen清單]來篩選想看的值,因此我們可以做一個表示各列狀態,內含[True, False, ......]的清單並傳入dataframe,即可輸出指定的列
另外大家可以想想看若想找異常大值該怎麼做。
了解如何用讀取大量wafer data後,用 Pandas 輸出 by wafer 以及二維分布資訊


 iThome鐵人賽
 看影片追技術